L'apprentissage supervisé est un type de technique de Machine Learning qui utilise des données labellisées pour entraîner des modèles à faire des prédictions. Dans l'apprentissage supervisé, un modèle apprend à effectuer une tâche de classification ou de régression à l'aide d'un ensemble connu de données d'entrée et de réponses.
Comment fonctionne l'apprentissage supervisé
L'apprentissage supervisé est le type de Machine Learning le plus répandu. Le modèle est entraîné à faire des prédictions sur la base d'un jeu de données connu (appelé jeu de données d'apprentissage) avec un ensemble connu de données d'entrée (appelées caractéristiques) et de réponses connues. Le jeu de données d'apprentissage inclut des données d'entrée labellisées ainsi que les sorties ou valeurs de réponses attendues correspondantes. À partir de ce jeu de données, l'algorithme d'apprentissage supervisé cherche à créer un modèle en déduisant les relations entre les caractéristiques et les données de sortie, puis prédit les valeurs de réponse sur un nouveau jeu de données.
L'apprentissage supervisé peut être utilisé dans plusieurs domaines scientifiques et techniques pour développer des modèles qui résolvent des problèmes du monde réel. Prenons l'exemple de cliniciens disposant de données sur d'anciens patients, notamment leur âge, leur poids, leur taille et leur tension artérielle. Sachant si ces patients ont eu des crises cardiaques, ils souhaitent prédire si un nouveau patient est à risque. Pour y parvenir, ils peuvent utiliser l'apprentissage supervisé afin de modéliser les données existantes.

Les phases d'apprentissage et d'inférence dans l'apprentissage supervisé.
Un workflow d'apprentissage supervisé type comprend des étapes telles que la préparation des données, la sélection de l'algorithme, l'apprentissage du modèle et l'évaluation du modèle. Étant donné que l'apprentissage supervisé repose sur des données labellisées pour entraîner les modèles, il est essentiel que les données d'apprentissage soient réalistes. Par exemple, si le modèle doit être utilisé dans un environnement bruité, les données d'apprentissage doivent également contenir des niveaux de bruit réalistes. La validation est une autre étape importante dans l'apprentissage supervisé, afin de s'assurer que le modèle se généralise bien face à de nouvelles données et d'éviter le surapprentissage.
Amélioration du modèle d'apprentissage supervisé
L'amélioration d'un modèle d'apprentissage supervisé, c'est-à-dire l'augmentation de sa précision et de son pouvoir prédictif, implique souvent l’ingénierie des caractéristiques et le réglage des hyperparamètres. L'ingénierie des caractéristiques consiste à transformer des données brutes en caractéristiques qui seront utilisées comme entrées d'un modèle de Machine Learning. Le réglage des hyperparamètres consiste à identifier l'ensemble de paramètres qui propose le meilleur modèle.

Application de l'ingénierie des caractéristiques et du réglage des hyperparamètres pour améliorer les performances d'un modèle d'apprentissage supervisé.
L'ingénierie des caractéristiques comprend des étapes comme la sélection des caractéristiques et leur transformation. Dans la sélection des caractéristiques, vous identifiez les caractéristiques (ou variables) les plus pertinentes qui offrent la meilleure capacité prédictive pour la modélisation de vos données. Au cours de la transformation des caractéristiques, les caractéristiques existantes sont transformées en nouvelles caractéristiques à l'aide de l'analyse en composantes principales, de la factorisation par matrices non négatives, de l'analyse factorielle et d'autres techniques.
Dans le cadre du réglage des hyperparamètres, vous essayez de trouver les meilleurs réglages pour les paramètres qui contrôlent le processus d'apprentissage, tels que le taux d'apprentissage, la taille des lots et le nombre d'epochs.
Apprentissage supervisé vs apprentissage non supervisé
L'apprentissage supervisé et l'apprentissage non supervisé sont tous deux des types de Machine Learning.

Deux types de Machine Learning : l'apprentissage supervisé et l'apprentissage non supervisé.
La principale différence entre l'apprentissage supervisé et l'apprentissage non supervisé réside dans le fait que l'apprentissage supervisé nécessite des données d'apprentissage labellisées pour entraîner un modèle de Machine Learning. En revanche, l'apprentissage non supervisé utilise des données non labellisées pour mettre au jour des relations cachées dans les données sans intervention humaine. Les résultats de l'apprentissage supervisé peuvent être plus précis que ceux de l'apprentissage non supervisé en raison de la présence de données labellisées. Cependant, l'acquisition de données labellisées nécessite souvent un effort humain et peut s'avérer longue, coûteuse et peu pratique dans certains cas.
Avant d'appliquer l'apprentissage supervisé, on utilise parfois l'apprentissage non supervisé pour découvrir des patterns dans les données d'entrée et identifier des caractéristiques pour l'apprentissage supervisé. En plus d'identifier les caractéristiques, il est nécessaire de déterminer la catégorie ou la réponse correcte pour toutes les observations du jeu d'apprentissage. L'apprentissage semi-supervisé, qui est également une technique de Machine Learning, vous permet d'entraîner des modèles avec moins de données labellisées et donc de réduire l'effort de labellisation.
Types d'apprentissage supervisé
Les principaux types de modèles de Machine Learning créés par des algorithmes d'apprentissage supervisé sont les modèles de classification et de régression. Pour chaque type de tâche, classification ou régression, différents algorithmes peuvent être utilisés pour modéliser vos données.

Types d'algorithmes d'apprentissage supervisé.
Apprentissage supervisé pour la classification
Dans l'apprentissage supervisé, la classification consiste à séparer les données en classes ou catégories spécifiques. L'objectif est d'attribuer une classe (ou une étiquette) issue d'un jeu limité de classes à une observation. Autrement dit, les réponses d'un modèle de classification sont des variables catégorielles.
Les applications les plus représentatives concernent l'imagerie médicale, la reconnaissance vocale et l’évaluation du risque de crédit. Il s'agit par exemple de déterminer si un e-mail est légitime ou indésirable, ou si des pièces d'équipement sont défectueuses ou en bon état.
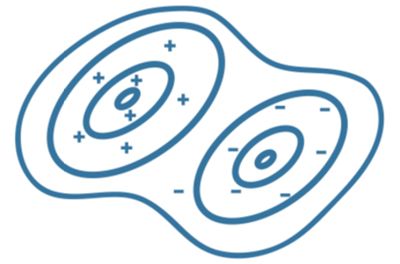
| La régression logistique ajuste un modèle capable de prédire la probabilité qu'une réponse binaire appartienne à une classe ou à l'autre. | L’analyse discriminante classe les données en trouvant des combinaisons linéaires de caractéristiques, en partant du principe que différentes classes génèrent des données basées sur des distributions gaussiennes. | La méthode des k plus proches voisins (kNN) catégorise les objets en fonction des classes de leurs plus proches voisins dans le jeu de données. Les prédictions kNN supposent que des objets proches les uns des autres sont similaires. | Les classificateurs naïfs bayésiens partent du principe que la présence d'une caractéristique dans une classe est indépendante des autres caractéristiques. Les nouvelles données sont classées en fonction de la probabilité la plus élevée qu'elles appartiennent à une classe particulière. |

|

|

|
|
Apprentissage supervisé pour la régression
Les techniques de régression en apprentissage supervisé permettent de comprendre la relation entre les variables de réponse et les variables d’entrée. Elles sont utiles pour des jeux de données comportant une plage de valeurs ou lorsque la réponse est un nombre réel, comme la température ou le délai avant la défaillance d’un équipement. Autrement dit, les modèles de régression prédisent des réponses continues. Les applications typiques comprennent la prévision de la consommation électrique, la prédiction de la durée de vie restante des batteries, le trading algorithmique, l’incidence des maladies, la prévision des cours boursiers et le traitement du signal acoustique.
| La régression linéaire est une technique de modélisation statistique utilisée pour décrire une variable de réponse continue comme une fonction linéaire d'une ou plusieurs variables prédictives. Les modèles de régression linéaire étant faciles à interpréter et à entraîner, ils constituent souvent le premier modèle à être ajusté à un nouveau jeu de données. | La régression non linéaire est une technique de modélisation statistique qui permet de décrire des relations non linéaires dans des données expérimentales. Les modèles de régression non linéaire sont généralement considérés comme paramétriques, le modèle étant décrit comme une équation non linéaire. | Les modèles linéaires généralisés, une catégorie particulière de modèles non linéaires, utilisent des méthodes linéaires. Ils consistent à ajuster une combinaison linéaire des entrées à une fonction non linéaire (la fonction lien) des sorties. |

|

|

|
Apprentissage supervisé pour la classification ou la régression
Plusieurs algorithmes d’apprentissage supervisé peuvent être utilisés pour des tâches de classification et de régression.
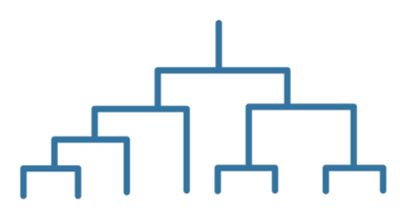
| Les arbres de décision vous permettent de prédire les réponses pour des données en suivant les décisions dans l'arbre depuis la racine (début) jusqu'à un nœud feuille. Un arbre se compose de conditions de branchement où la valeur d'un prédicteur est comparée à un poids entraîné. Le nombre de branches et les valeurs des poids sont déterminés lors de l’apprentissage. | Les machines à vecteurs de support (SVM) classent les données en trouvant l'hyperplan séparant le mieux tous les points de données d'une classe de ceux d'une autre classe. Pour la régression SVM, au lieu de trouver un hyperplan qui sépare les données, les algorithmes déterminent un modèle qui s'écarte des données mesurées d'une valeur ne dépassant pas une faible quantité, avec des valeurs de paramètres aussi petites que possible (afin de minimiser la sensibilité à l'erreur). | Les réseaux de neurones sont des systèmes adaptatifs qui apprennent en utilisant des nœuds ou des neurones interconnectés au sein d'une construction en couches semblable à celle d'un cerveau. Un réseau de neurones peut apprendre à partir de données ; il peut donc être entraîné à reconnaître des patterns, classer des données et prévoir des événements futurs. Le comportement d’un réseau de neurones est défini par la manière dont ses éléments individuels sont connectés et par la force (ou poids) de ces connexions. Ces poids sont ajustés automatiquement pendant l’apprentissage. |
|

|

|
Le Deep Learning, une forme spécialisée de Machine Learning, exploite des réseaux de neurones profond pour traiter des tâches complexes et des jeux de données volumineux. Les algorithmes courants de Deep Learning tels que les réseaux de neurones à convolution (CNN), les réseaux de neurones récurrents (RNN) et les réseaux LSTM (long short-term memory) sont généralement supervisés.
Choix du bon algorithme d’apprentissage supervisé
Lorsque vous choisissez un algorithme d’apprentissage supervisé pour vos données, vous devez tenir compte des compromis entre les différents algorithmes, tels que leurs besoins en calcul et en mémoire, leur précision prédictive et leur interprétabilité. Ce processus, susceptible d'impliquer du tâtonnement (essai-erreur), peut être facilité en appliquant le Machine Learning automatisé (AutoML).

Compromis entre puissance de prédiction et interprétabilité pour plusieurs algorithmes d’apprentissage supervisé.
Pourquoi l'apprentissage supervisé est important
L’apprentissage supervisé est un domaine majeur du Machine Learning et de l’intelligence artificielle. Ingénieurs et scientifiques utilisent l’apprentissage supervisé pour créer des modèles d’IA afin de résoudre des problèmes concrets. Par exemple, dans la modélisation de capteurs virtuels, les modèles d’IA utilisés pour développer ces capteurs sont entraînés avec des algorithmes d’apprentissage supervisé. Quelques domaines d’application de l’apprentissage supervisé :
- Bioinformatique et équipements médicaux : les techniques d’apprentissage supervisé sont largement utilisées dans le domaine de la santé pour l’imagerie médicale, la détection de tumeurs et la découverte de médicaments. L’apprentissage supervisé peut également être utilisé pour des tâches basées sur le signal, comme la classification des données ECG afin de faire la distinction entre une arythmie, une insuffisance cardiaque congestive et un rythme sinusal normal.
- Production d'énergie : en utilisant l’apprentissage supervisé pour la régression, les ingénieurs peuvent prédire les prix de l’énergie, prévoir la charge électrique et créer des modèles pour diverses applications d’énergie renouvelable.
- Automatisation industrielle : l’apprentissage supervisé peut être utilisé afin de développer des modèles prédictifs pour la détection d’anomalies, la détection de défaillances et le diagnostic.
- Finance quantitative et évaluation des risques : les algorithmes d’apprentissage supervisé sont utilisés pour l’évaluation du risque de crédit, le trading algorithmique, la prévision des cours boursiers et la classification d’obligations.
Exemple concret d’apprentissage supervisé
L’état de charge (SOC) d’une batterie électrique correspond à son niveau de charge par rapport à sa capacité, mesuré en pourcentage. Dans de nombreuses applications, comme dans les véhicules électriques, ce SOC doit être estimé avec précision. L’estimation du SOC des batteries lithium-ion à l’aide d’une approche de modélisation basée sur la physique est très complexe, en raison des conditions de fonctionnement diverses et de la variabilité importante des dispositifs, même pour des batteries du même fabricant.
Utiliser l’apprentissage supervisé afin de créer un modèle prédictif pour l’estimation du SOC est une approche basée sur les données qui peut aider à relever ces défis. Le modèle peut prédire l’état de charge de la batterie lithium-ion d’un véhicule à partir de données temporelles représentant diverses mesures de la batterie, telles que la tension, l'intensité et la température, ainsi que des caractéristiques dérivées comme la tension et l'intensité moyennes. En savoir plus sur cet exemple.

SOC réel et prédit à l’aide d’un modèle de régression par processus gaussiens dans Statistics and Machine Learning Toolbox. (Voir le code.)
Pour continuer à explorer ce sujet
Apprentissage supervisé avec MATLAB
MATLAB® vous permet d’appliquer l’apprentissage supervisé et de concevoir des modèles prédictifs. Vous pouvez entraîner, valider et ajuster des modèles d’apprentissage supervisé avec Statistics and Machine Learning Toolbox™ et Deep Learning Toolbox™. Vous pouvez combiner les outils de Machine Learning et de Deep Learning avec d’autres toolboxes MATLAB pour exécuter des workflows spécifiques à votre industrie. Grâce aux fonctions prédéfinies et aux applications interactives, vous pouvez traiter et annoter les données, entraîner des modèles, visualiser les performances de ces derniers et ajuster les hyperparamètres afin d’en améliorer les performances.
Préparation des données
MATLAB supporte les signaux, les données visuelles et les données textuelles. Vous pouvez accéder à vos données et les explorer via la ligne de commande ou de manière interactive en utilisant des applications low-code :
- Choisissez une application pour labelliser les données de vérité-terrain servant à valider ou entraîner des algorithmes d’apprentissage supervisé tels que les classificateurs d’images, les détecteurs d’objets, les réseaux de segmentation sémantique et les applications de Deep Learning.
- Utilisez l’application Data Cleaner et la tâche de prétraitement de données du Live Editor pour prétraiter les données.

Application des étapes de prétraitement des données à l’aide de Data Cleaner dans MATLAB. (Consulter la documentation.)
Pour l’ingénierie des caractéristiques, MATLAB propose des outils intégrés pour la plupart des méthodes d’extraction et de sélection de caractéristiques.
Modélisation de l’IA avec des applications low-code
Les applications Classification Learner et Regression Learner vous aident à appliquer l’apprentissage supervisé au design, au réglage, à l’évaluation et à l’optimisation de modèles de Machine Learning pour la classification et la régression. Avec ces applications de Machine Learning, vous pouvez :
- Entraîner des modèles selon différents algorithmes de Machine Learning.
- Visualiser les résultats et évaluer les performances des modèles.
- Comparer les performances de plusieurs modèles.
- Générer automatiquement du code pour un modèle entraîné.
- Exporter un modèle entraîné vers l’espace de travail, Simulink® et MATLAB Production Server™.
Application Classification Learner

Application Regression Learner

Avec l'application Deep Network Designer, vous pouvez concevoir, analyser et modifier des réseaux de Deep Learning de manière interactive. Vous pouvez également charger des réseaux pré-entraînés ou importer des réseaux depuis PyTorch® et TensorFlow™.

Design d’un réseau de neurones profond à l’aide de l’application Deep Network Designer dans MATLAB. (Consulter la documentation.)
Au-delà de la modélisation de l’IA, avec l’application Experiment Manager, vous pouvez importer et gérer plusieurs expérimentations de Machine Learning et de Deep Learning, assurer le suivi des paramètres d’apprentissage, ajuster les hyperparamètres, analyser les résultats et comparer le code issu de différentes expérimentations.
Apprentissage supervisé et IA embarquée
Avec MATLAB et Simulink, vous pouvez concevoir, simuler, tester, vérifier et déployer des modèles d'IA conçus grâce à l'apprentissage supervisé qui améliorent les performances et les fonctionnalités des systèmes embarqués complexes. Utilisez des blocs Simulink dédiés pour simuler et tester l’intégration des modèles d’IA dans des systèmes complexes. Générez automatiquement un code optimisé pour le déploiement sur des cibles limitées en actifs.
L’apprentissage supervisé est une technique de Machine Learning qui utilise des données étiquetées pour entraîner des modèles à réaliser des prédictions. L’algorithme apprend à partir d’un ensemble connu de données d’entrée (caractéristiques) associé à des réponses ou sorties connues.
Les deux principaux types sont la classification, qui prédit des réponses catégorielles, par exemple déterminer si une pièce d’équipement est défectueuse ou fonctionnelle, et la régression, qui prédit des valeurs continues telles que la charge du réseau électrique ou l’état de charge d’une batterie.
L’apprentissage supervisé nécessite des données d’entraînement étiquetées comportant des entrées et des sorties connues, tandis que l’apprentissage non supervisé exploite des données non étiquetées afin de découvrir des motifs cachés sans intervention humaine. Les résultats obtenus avec l’apprentissage supervisé sont généralement plus précis, mais nécessitent un processus d’étiquetage souvent long et potentiellement coûteux.
Parmi les applications courantes figurent l’imagerie médicale et la détection de tumeurs, la classification de signaux ECG, la prévision de la charge électrique, l’évaluation du risque de crédit, la détection d’anomalies dans l’automatisation industrielle et l’estimation de l’état de charge des batteries dans les véhicules électriques.
Les arbres de décision, les Support Vector Machines (SVM) et les réseaux de neurones peuvent être utilisés aussi bien pour des tâches de classification que de régression dans le cadre de l’apprentissage supervisé.
L’amélioration d’un modèle repose sur l’ingénierie des caractéristiques (feature engineering), notamment la sélection et la transformation des caractéristiques, ainsi que sur l’optimisation des hyperparamètres afin d’identifier les paramètres offrant les meilleures performances, tels que le taux d’apprentissage, la taille des lots (batch size) ou le nombre d’époques d’entraînement.
MATLAB propose les applications Classification Learner et Regression Learner pour entraîner et évaluer des modèles de Machine Learning, l’application Deep Network Designer pour les réseaux de neurones, ainsi que des outils de prétraitement des données, d’ingénierie des caractéristiques et de déploiement de modèles sur des systèmes embarqués.
Les données étiquetées fournissent les paires entrée-sortie correctes qui permettent au modèle d’apprendre les motifs et les relations présents dans les données, influençant directement la précision des prédictions. La qualité et le réalisme des données étiquetées jouent un rôle essentiel dans les performances du modèle et sa capacité à se généraliser à de nouvelles données.
Ressources
Développez vos connaissances grâce à la documentation, aux exemples, aux vidéos et plus encore.

Documentation

En savoir plus
Sujets connexes
Explorez des sujets similaires pour lesquels on utilise couramment les produits MATLAB et Simulink.

Essayer gratuitement
Commencer
